SEOとは?初心者向けに施策や事例を紹介
SEO対策
最終更新日:2026.10.01

更新日:2026.10.14
私は、株式会社PLAN-BマーケティングパートナーズでAIマーケティング本部の本部長として、日々、AI検索対策の支援に向き合っています。中でも、特に難しさを感じるのは成果の計測です。
ツールを使えば数字は出ます。ただ、それが何を、どのような定義に基づいて計測した数字なのか、私自身も立ち止まって考えることが少なくありません。
そんな中、IAB(Interactive Advertising Bureau)が2026年8月に公開したレポートで示された整理が非常にわかりやすかったので、私たちが実際に計測してみて感じたことと合わせて紹介します。
まず、3つの難しさを整理すると次のとおりです。
| 難しさ | 何が起きるか | 測定への影響 |
|---|---|---|
| ①用語が揃っていない | 言及・参照・引用などの言葉の定義が会社ごとに異なる | 同じ名称の指標を比較できない |
| ②AIの回答はブレる | 同じ質問でも企業・情報源・表現が毎回変わる | 1回の回答では傾向を判断できない |
| ③判定基準が語られていない | センチメントや誤りの判定方法が見えない | 数値の再現性・比較可能性が下がる |
IABはレポートの中で、20社以上の企業がAI検索状況の計測ツールを販売をしているのに対し、企業ごとに用語が不揃いであることを指摘しています。計測方法・プロンプト・対象AI・採点方法が異なるだけでなく、「mention(メンション)」や「citation(サイテーション)」が何を指すかの基準もないことを指摘しています。
さらに私が見る限り、日本の市場では訳語も問題になっています。
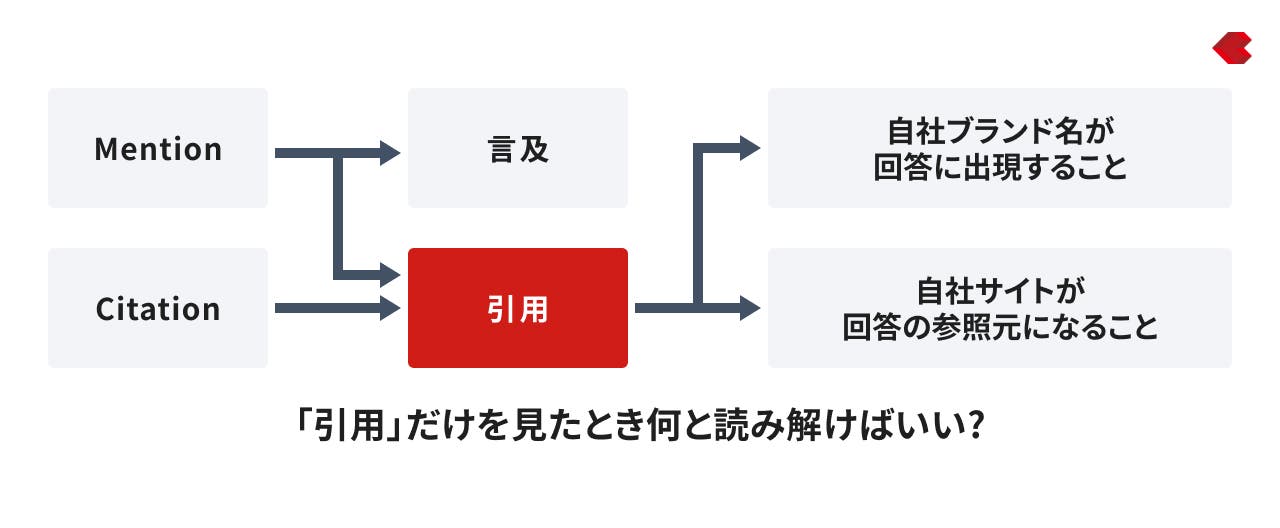
Mention、Citation、Referenceの3語を「言及・引用・参照」と訳している場合もあれば、Mentionを「引用」と訳している場合もありました。「引用」という言葉が、AIの回答に自社ブランド名が出ることを指している場合もあれば、自社サイトが回答の情報源になることを指している場合もあるのです。
引用数が30件ですと言われても、それだけでは何も判断ができません。
同じ問いを同じAIに投げても、挙がる会社、根拠にする情報源、書き方は毎回変わります。これはAIが文章を生成する仕組みそのものなので、設定を工夫しても完全になくすことはできません。
「おすすめのSEOコンサルティング会社を教えてください。」という問いをChatGPTとGeminiに100回ずつ投げたところ、回答に挙がった会社は、重複を除いてChatGPTで76社、Geminiで17社でした。この記事では、以降この調査を例に使います。
🔎 今回の調査条件
ChatGPTの場合、1回の回答に挙がるのは平均5社ほどです。それが100回分では76社になるということは、回答ごとに顔ぶれが入れ替わっているということです。
ですから、ある1回の回答に自社の名前があった、あるいは無かったというだけでは、それがいつもの結果なのか、たまたまなのかはわかりません。
センチメント(好意的か否定的か)やハルシネーションのような指標は、判定の基準を決めないと数字になりません。
たとえば「実績が豊富」は、事実の記述として中立に数えるのか、褒め言葉として好意的に数えるのかで評価が変わります。「価格が高い」の「高い」は否定的ですが、「精度が高い」の「高い」は好意的です。同じ語でも、文脈で向きが変わります。
ハルシネーションも同様で、何をもって誤りとするのか。誤りだとして、それはAIの出力のミスなのか、AIが読んだ情報源が誤っていたのか。
こうした基準が示されないまま、センチメントスコアやハルシネーション率という数字だけが示されているケースが多くあります。基準が分からない数値は、他の数値と比べることができません。
IABは2026年8月、AI可視性の測定に関するレポート「Measuring Visibility in the AI Era」を公開しました。
レポートの中心にあるのが、指標を4つの層に整理した「4つのP」です。
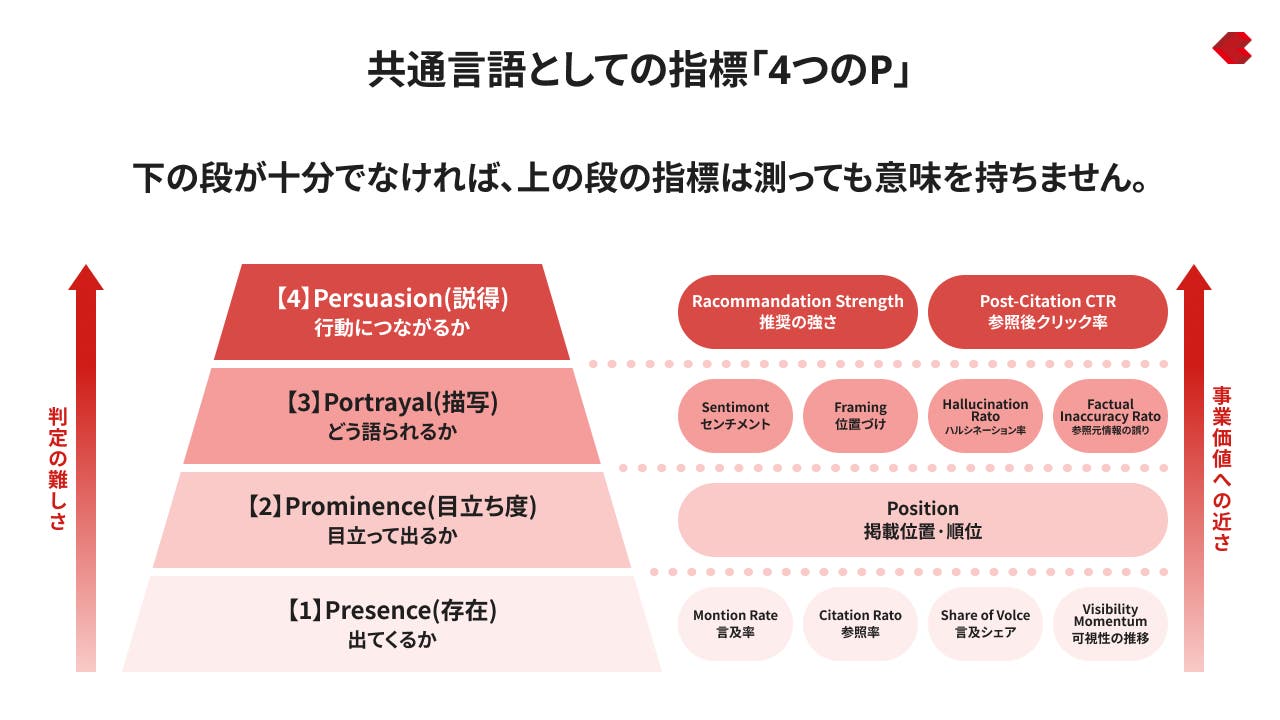
下から上へ進むほど事業成果に近づく一方、測定は難しくなります。Presenceが土台で、名前が出なければその先の指標は計算できません。
| 階層 | 問い | 指標 |
|---|---|---|
| Presence(存在) | 名前が出るか | 言及率、参照率、言及シェア、推移 |
| Prominence(目立ち度) | どこに、どれだけ目立って出るか | 順位 |
| Portrayal(描写) | どう語られるか、どれだけ正確か | センチメント、位置づけ、ハルシネーション率、参照元情報の誤り率 |
| Persuasion(説得) | 推奨され、行動につながるか | 推奨の強さ、参照後のクリック率 |
私がこれをわかりやすいと感じたのは、先ほどの3つの難しさそれぞれに、対応策が示されていたからです。
①用語の不統一への対応:指標ごとに定義を置き、あわせて「測り方をどう選んだかを開示せよ」と求めています。
②回答のブレへの対応:「1回の回答は測定ではない」と書いています。可視性は1つの値ではなく分布として扱い、幅をつけて報告し、AIごとに分けて報告する、としています。
③判定基準の不透明さへの対応:センチメントは分類の方法と精度を開示せよ、と求めています。「ハルシネーションと参照元情報の誤りを分け、前者はAI側の問題、後者は情報源側の問題として、対処法が違う。また、正解データはブランドが用意する」としています。
この記事では、IABの用語を次のように訳して使います。
| IABの用語 | この記事での表記 | 定義 |
|---|---|---|
| Mention | 言及 | AIの回答にブランド名が出ること |
| Citation | 参照 | 自社サイトが回答の情報源として使われること |
| Recommendation | 推奨 | 特定の相手に向けてブランドを勧めること |
| Position | 順位 | 回答内でブランドが登場した順番や位置 |
| Sentiment | センチメント | ブランドが好意的・中立・否定的のどれで語られるか |
| Framing | 位置づけ | ブランドがどのような特徴や役割で語られるか |
| Hallucination | ハルシネーション | どの情報源にも根拠がない記述 |
| Factual Inaccuracy | 参照元情報の誤り | 情報源自体の誤りに基づく記述 |
引用という言葉は使いません。名前が出ることを指すのか、情報源になることを指すのかが、人によって解釈が分かれる語だからです。
また、Reference(AIが検索時に参照したURL一覧)はツール側の用語で、IABの指標にはありません。そのため、この記事では扱わないこととします。
Presence(プレゼンス)は、他の3つの層を支える最初の層です。そのブランドがAIの回答に出てくるかを測ります。
IABは、ここに4つの指標(言及率/参照率/言及シェア/可視性の推移)を置いていますが、この記事では言及率と参照率の2つを取り上げます。
IABの定義は次のとおりです。
IABは、言及率を語られているか、参照率を頼られているかと言い分け、2つの差にも意味があると書いています。
以下は、今回の調査における弊社の言及率・参照率です。
| 指標 | ChatGPT | Gemini |
|---|---|---|
| 言及率 | 75%(75/100) | 99%(99/100) |
| 参照率 | 74%(74/100) | 4%(4/100) |
Geminiは弊社の名前を99回出しましたが、弊社のサイトを参照したのは4回でした。名前は、弊社のサイトではなく第三者の記事から来ています。
ChatGPTは逆で、名前を出した回答のほとんどで弊社のサイトを読んでいました。
同じブランド、同じ問いでも公式サイトを読んで答えるAIと、ほとんど読まないAIがあります。IABの言う「差にも意味がある」とは、こういう状態のことです。
Presenceは、4つの層の中で最も測りやすい層です。それでも1つ、決めておくことがあります。
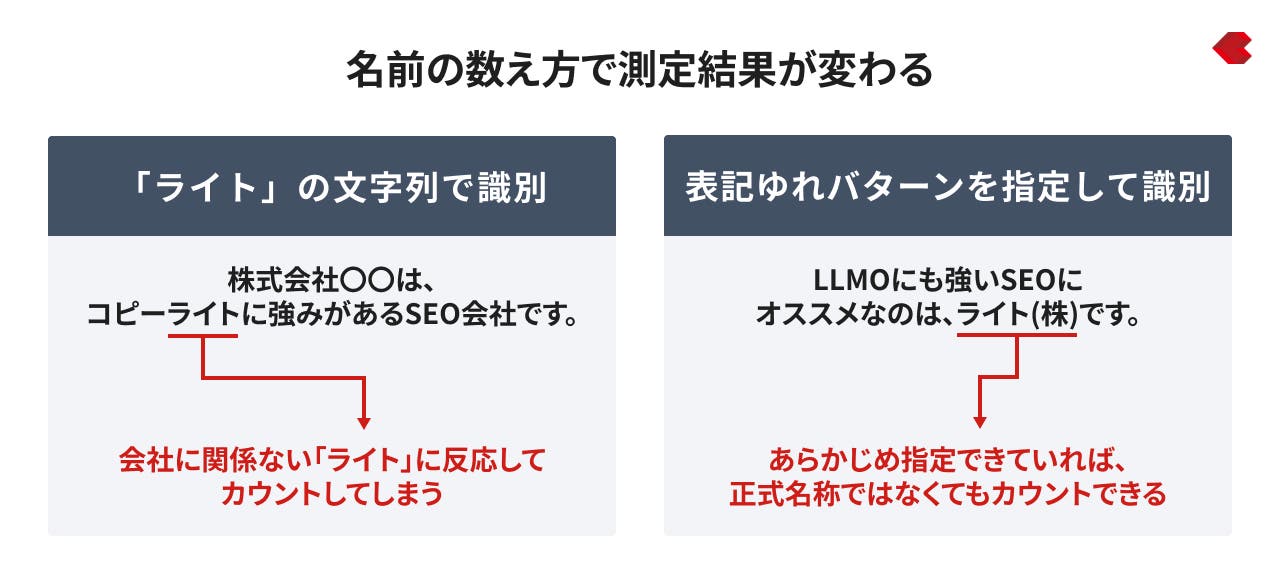
「名前が出た」を、文字列の一致で数えるか、その会社を指しているか(エンティティの一致)で数えるかです。
仮に「株式会社ライト」というSEO会社があるとします。「ライト」という文字列の一致で判別すると、「ハイライト」「コピーライト」のような一般的な語や、「株式会社ハイライト」という別の会社まで、株式会社ライトの言及として数えてしまいます。
逆に、AIは「ライト社」「LIGHT(ライト)」「ライト(株)」のように書くので、「株式会社ライト」という正式名称だけで探すと取りこぼします。
だから測定では、会社ごとに表記の一覧を作り、それを回答と照合するのです。一覧に無い名前は1件も拾えません。この調査でも、200件の回答から社名を拾い出し、最終的に114社を一覧に登録しました。
Prominence(プロミネンス)は、名前が出たとして、それが回答のどこに、どれだけ目立って出ているかという層です。
IABは順位(Position)を、5つに分けて測定しています。
AIが箇条書きで回答した場合は測定しやすいとIABは書いています。
ただし、文章の回答では決まった形がないので、どう測ったかの開示が要るとしています。回答の全文で測ったか、スクリーンショットで測ったか、最初に画面に見える範囲だけで測ったかも開示が必要です。
今回の調査結果は、次のとおりです。
| 指標 | ChatGPT | Gemini |
|---|---|---|
| 弊社が最初に挙がった割合 | 34.7%(26/75) | 0%(0/99) |
Geminiでは、100回の回答で最初に挙がった会社は3社に集中し、それぞれ78回・12回・10回でした。
ただし、名前が多く挙げられるからといって、必ずしも1番目に出ているとは限りません。
「1番目」は、順位の定義を決めないと数えられません。
Geminiの回答は、ほぼすべてが以下のような形をしています。
1. ツールを活用した分析・内製化に強い会社
A社、B社
2. コンテンツマーケティング・伴走支援に強い会社
C社、D社
3. 戦略設計・総合的なWebマーケティングに強い会社
株式会社PLAN-B、E社
4. ベンチャー・中小企業・柔軟な支援に強い会社
F社
この回答における弊社の順位は、数え方によって変わります。
| 数え方 | 弊社の位置 | 補足 |
|---|---|---|
| 本文の先頭から数える | 5番目 | 今回採用した定義 |
| グループ内で数える | 1番目 | グループごとに順位を数える場合 |
| 画面上の見え方で測る | 3つ目の見出しまでスクロールした先 | 画面サイズや表示状態にも左右される |
IABが文章の回答では方法の開示が要ると書いた理由は、ここにあります。
今回の調査では、回答の本文全体を対象に、頭から数えた順を順位としています。画面に表示された状態ではなくテキストで測り、比較記事を出している媒体の名前とツールの名前は順位に入れていません。
先ほどの0%は、この定義で数えた結果です。グループの中の順で数え直しても、弊社が1番目になる回答は99回のうち2回でした。
順位を見るときは、その順位がどう決められたかを一緒に見る必要があります。
Portrayal(ポートレイヤル)は、ブランドの語られ方についての層です。IABはこの層に、センチメント、位置づけ(Framing)、ハルシネーション率、参照元情報の誤り率の4つの指標を置いています。
この層は、2つの観点に分けられます。「どう語られているか」という評判と、「正しく語られているか」という正確さです。
まずはどう語られているかを表すセンチメントから見ていきましょう。
IABはセンチメントについて、商品を勧める文脈では中立的な記述が多くなり、比較表現では判定が不安定になると書いています。そのうえで測定会社には、分類の方法と精度を開示せよと求めています。
今回の調査における全記述の傾向は、次のとおりです。
| 集計 | ChatGPT | Gemini |
|---|---|---|
| 全記述数 | 515件 | 673件 |
| センチメントの傾向 | すべて中立 | 約9割が好意的 |
同じ会社についても、2つのAIは異なる書き方をしています。
| AI | 回答例 | 読み取り |
|---|---|---|
| ChatGPT | 「PLAN-B:SEO対策/コンサルの一覧記事で登場」 | どこに掲載されているかを説明しており、評価語がない |
| Gemini | 「15年以上の実績があり、わかりやすいコンサルティングに定評がある」 | 何が得意かを評価する表現が含まれる |
弊社に関する判定結果は、次のとおりです。
| 指標 | ChatGPT | Gemini |
|---|---|---|
| 好意的である割合 | 0% | 76.8%(20回以上名前が出た9社中最下位) |
| 否定的な記述 | 0件 | 0件 |
ChatGPTの好意的である割合が0%なのは、弊社が低く見られているからではなく、評価する語が出てくる文型になっていないからです。
とはいえ、この好意的・否定的という判定は、客観的で絶対的なものではありません。実際に判定していて迷った箇所を2つ挙げます。
| 記述 | 迷う点 | 今回の判定基準 |
|---|---|---|
| 「15年以上の実績があり」 | 年数の事実か、褒め言葉か | 年数や件数は中立とし、「豊富」「多数」などの形容が付いた場合だけ好意的と数える |
| 「特徴・強みが整理されている」 | 「強み」が弊社ではなく比較記事を説明している | 語句の有無だけでなく、何を説明しているかを確認して判定する |
どちらも、読み方によって判定が分かれる余地があります。だから私たちは判定基準を決めて開示したうえで、記述と判定結果を人が確認する工程を挟んでいます。IABが分類の方法の開示を求めているのも、このためです。
さらに難しいのが、事実かどうかの判定です。
IABは、正確性をハルシネーションと参照元情報の誤りの2つに分けています。
ハルシネーションは、どの情報源にも根拠がない記述です。参照元情報の誤りは、情報源には書いてあるが、その情報源が誤っている記述です。
前者はAI側の問題、後者は情報源側の問題で、対処法が違います。
この調査では正確性を測っていませんが、作業の中で次の記述がありました。
| AIの記述 | 確認できる事実 | この時点での判定 |
|---|---|---|
| 「株式会社PLAN-Bが(他社のツール名)を開発・提供」 | 弊社のツールは「SEARCH WRITE」であり、記載されたツールは他社のもの | どの情報源に基づく記述か分からないため、ハルシネーションか参照元情報の誤りかを区別できない |
IABの区分では対処法が変わります。判断するには、2つの情報が必要です。
1つ目は、その記述がどの情報源から来たかです。
Geminiは出典を回答全体にまとめて付けるので、どの文がどのサイトから来たかを特定できません。この1件も、根拠にした8つのサイトのどれから来たかはわかりませんでした。
ChatGPTは文ごとに出典を付けるので、参照元をたどれます。見分けられるかどうかは、測る側の力量ではなく、AIの仕様で決まります。
2つ目は、何が正しいかを決める正解データです。IABは、これはブランドが用意するものだとしています。
この2つ目の「何を正解とするか」を注意点としてあげます。
正解にできるのは、価格・仕様・年・沿革など、公式情報で確認できる事実です。「本当はこう語られたい」というブランドの意図は、正解データにはなりません。
たとえば古いイメージのまま語られているという記述は、ブランドとしては直したいものですが、事実の誤りではなく位置づけ(Framing)の問題です。これを誤りに混ぜると、誤りの件数がブランドの意図次第で膨らみます。
私たちも過去、位置づけの問題と参照元情報の誤りを混同して数えてしまい、分類を分けてやり直した経験があります。
そのうえで、公式サイトに書かれていないことを誤りと数えない、という判定基準を置きます。
たとえば、「わかりやすいコンサルティングに定評がある。」という表記はどうでしょうか?
「定評がある」は、公式サイトに書ける事実ではありません。これは検証できない記述であって、誤りではありません。裏を返せば、こうした記述の一覧は、公式が語っていないことの一覧になります。
誤りでないものを誤りと数えないことを優先し、一定の見逃しは許容する。この方針で判定するため、報告する件数は少なくなります。
IABは、評判と正確さの双方に定義を示しています。ただし、その定義を一つひとつの記述に当てる判定基準は、測る側が決めるしかありません。
Persuasion(パースエージョン)が見るのは、推奨されているかと行動につながっているかです。4つの層の中では、最も事業成果に近く、同時に最も測りにくい領域です。
IABは推奨の強さ(Recommendation Strength)を、以下のパターンのどれに当てはまるか確認します。
この判定には主観が入りうるため、採点基準を開示せよと求めています。
今回の調査結果は、次のとおりです。
| 指標 | ChatGPT | Gemini |
|---|---|---|
| 推奨に該当する記述 | 0件/515件(0%) | 93件/673件(約14%) |
| 条件つきの推奨 | 0件 | 92件 |
| 無条件の推奨 | 0件 | 1件 |
20回以上名前が出た9社の中で、弊社は好意的である割合が最下位、推奨率は3位でした。好意的に語られれば推奨されるというわけではありません。
たとえば、弊社が推奨と数えられた記述は、こういう形です。誰に向けて勧めているかが、書かれています。
Geminiの回答
多くの支援実績を持つほか、独自のSEO・Webマーケティング分析ツール「SEARCH WRITE(サーチライト)」を開発・提供。コンサルティングを受けながら、自社でもデータ管理を行いたい企業に向いています。
難しいのは、何を推奨と数えるかです。Geminiが弊社について書いた2つの記述を比較します。
| 記述 | 判定 | 理由 |
|---|---|---|
| 「データドリブンなSEO戦略の立案に強みがあり、サイト全体のアクセス改善やCV最適化を総合的にサポートします」 | 説明 | 特徴や強みを述べていますが、誰かに勧めているわけではない |
| 「コンサルティングを受けながら、自社でもデータ管理を行いたい企業に向いています」 | 推奨 | どのような企業に勧めるかが明示されている |
今回の調査では、誰に向けて勧めているかが書かれている場合だけを推奨と数えました。説明まで推奨に含めると、語られ方(Portrayal)と推奨(Persuasion)が同じ数字になり、層を分けた意味がなくなります。
もう1つ、語句の一致だけで判別すると、誤って解釈するおそれがあります。
たとえば、「最適」という文字列が含まれているかどうかだけで推奨を判別すると、先ほどの「説明」の例にもある「コンバージョン(CV)最適化」や、検索エンジン最適化などに含まれる「最適」という文字列を拾ってしまいます。
「トップ」も同じで、「ワンストップ」「業界トップクラス」に含まれる文字列に一致します。
こうした誤検出を除外する前は、推奨に該当する記述が実際の3倍以上あるように見えていました。
今回の調査での弊社の立ち位置を、4つの層で並べてみます。
| 層 | ChatGPT | Gemini |
|---|---|---|
| 言及率 | 75% | 99% |
| 参照率 | 74% | 4% |
| 1番目に挙がった割合 | 34.7% | 0% |
| 好意的である割合 | すべて中立 | 76.8%(9社中最下位) |
| 推奨率 | 0% | 15.2%(9社中3位) |
※9社=今回の調査で20回以上名前が出た会社。
言及率だけを見れば、どちらのAIでも十分に名前が出ています。参照率を見ると、Geminiは弊社のサイトをほとんど読んでいません。最初に挙がった割合はChatGPTとGeminiで大きく異なり、Geminiでは好意的である割合が9社中最下位である一方、推奨率は3位でした。
どれか1つの層だけを見ていたら、まったく違う判断をしていたと思います。
用語の不統一と回答のブレはIABの考え方で対応できますが、判定基準だけは、測る側が自分で決めて開示するほかありません。
AI検索対策の数字を見るときは、まず4つの層のどこを測っている数字かを確認する。次に、どんな判定基準で数えた数字かを確認する。この2点だけでも、数字の見え方はかなり変わります。
もし、いま手元にAI可視性スコアのような1つの数字があるなら、それが4つの層のどこに当たる数字なのかを確かめることから始めてみてください。

フォームに必要事項をご記入いただくと、
無料で資料ダウンロードが可能です。
資料請求
ありがとうございました。
share


2018年に株式会社PLAN-Bへ新卒入社。SEO部門の責任者を務め、コンサルティングやメディア立ち上げ支援、サービス開発に従事。2026年よりAIマーケティング本部長に就任し、LLMOを軸とした企業のマーケティング支援に取り組むとともに、事業戦略などの上位レイヤーからの戦略設計を手がける。生成AIおよびAI時代のマーケティングに関する研究と実務知見を背景に、セミナー登壇や寄稿、専門家コラムの執筆など幅広く活動。
著書に「60分でわかる!LLMO超入門」がある。
先祖が武士で、思想も武士。出田で「いでた」と読みます。
愛読書:「ストーリーとしての競争戦略」
SEO対策
最終更新日:2026.10.01

SEO対策
最終更新日:2026.09.08
SEO対策
最終更新日:2025.12.25

SEO対策
最終更新日:2026.09.15
SEO対策
最終更新日:2025.07.29
SEO対策
最終更新日:2025.07.29
SEO対策
最終更新日:2026.09.18
SEO対策
最終更新日:2026.09.08